
Eine Betrachtung über Relativierung, Lautstärke und das stille Einverständnis der Maschinen
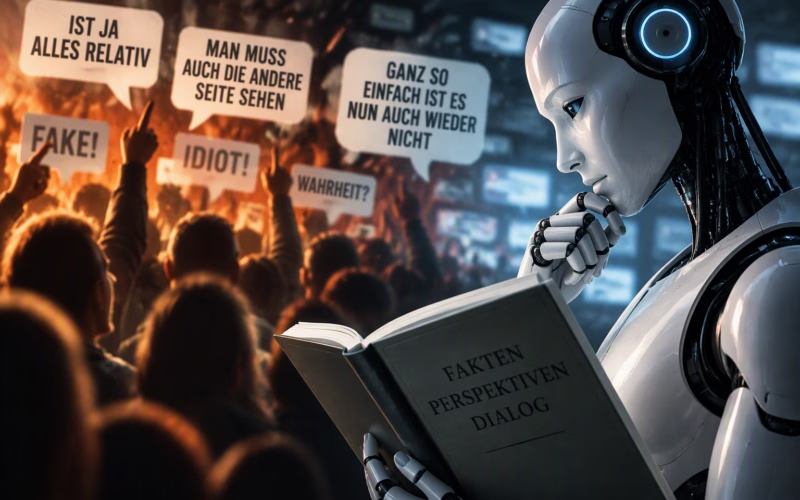
Es gibt Sätze, die klingen harmlos, fast schon höflich, und sind doch der sprachliche Weichspüler jeder sinnvollen Debatte. „Naja, das ist ja alles relativ“ gehört dazu. Oder: „Man muss auch die andere Seite sehen.“ Oder der Klassiker unter jedem zugespitzten Statement: „Aber ganz so einfach ist es nun auch wieder nicht.“ Diese Sätze können Ausdruck echter Differenzierung sein – oder eine Schutzmauer. Der Unterschied ist entscheidend: Wer differenziert, erkennt Komplexität und zieht daraus eine Schlussfolgerung. Wer reflexhaft relativiert, nutzt Komplexität, um sich vor der Schlussfolgerung zu drücken.
Woran lässt sich das unterscheiden? Echte Differenzierung ist an Bedingungen geknüpft: Sie sagt, unter welchen Umständen etwas gilt und welche Beobachtung sie umstimmen würde. Reflexhaftes Relativieren kennt solche Bedingungen nicht; es lässt sich von keiner Beobachtung mehr erreichen. Dabei ist nicht jedes Zögern verdächtig. Wer ehrlich unsicher ist und „Das weiß ich nicht“ sagt, ist nicht dumm, sondern redlich. Als Arbeitsdefinition dient mir daher Dietrich Bonhoeffer: Dumm im strengen Sinn ist, wer sich gegen Tatsachen immunisiert. Davon unterscheide ich zwei Verwandte, die ihr ähneln, ohne dasselbe zu sein: den Taktiker, der aus Kalkül ausweicht, und den Lauten, der Aufmerksamkeit bekommt, ob er recht hat oder nicht.
Der Titel behauptet, dass die Dummheit siegt, und zwar über den Umweg der Maschinen. Die These lautet: Die Dummheit hat im Netz mehr Raum, die KI lernt aus dem, was Raum hat, und sie glättet es beim Nachtraining auf Gefälligkeit; so verstärkt sie, was ohnehin laut ist. Das ist eine Kette aus vier Gliedern, und sie ist nicht überall gleich gut belegt. Deshalb kennzeichne ich jedes Glied:
- Raum: Im Netz haben die Lauten mehr Raum als die Leisen, und sie sind nicht repräsentativ. Status: belegt, mit Einschränkungen.
- Statistik: Was viel Raum hat, prägt, was ein Sprachmodell als normal lernt; Statistik kennt Häufigkeit, nicht Geltung. Status: plausibel; belegt sind Verzerrungen der Webdaten, nicht, dass sie „dumm“ wären.
- Weichspülen: Beim Nachtraining wird Gefälliges belohnt, und die Antworten werden einförmiger. Status: belegt.
- Sieg: Die Ergebnisse fließen zurück in den Diskurs und in künftige Trainingsdaten, sodass sich das Muster verstärkt. Status: offen; belegt ist nur die Rückkopplung als technisches Risiko.
Zunächst zum Begriff. Bonhoeffer notierte Ende 1942 in Widerstand und Ergebung: „Gegen das Böse läßt sich protestieren, gegen die Dummheit sind wir wehrlos. Weder mit Protesten noch mit Gewalt läßt sich hier etwas ausrichten; Gründe verfangen nicht.“[1] Er meinte damit ausdrücklich nicht den Menschen mit geringer Intelligenz. Dummheit ist bei ihm weniger ein psychologisches als ein soziologisches Phänomen: Sie entsteht dort, wo Menschen unter dem Eindruck von Parolen, Gruppendruck und fremder Machtentfaltung ihre innere Selbständigkeit verlieren. Und er beschreibt den Mechanismus präzise: „Tatsachen, die dem eigenen Vorurteil widersprechen, brauchen einfach nicht geglaubt zu werden – in solchen Fällen wird der Dumme sogar kritisch.“[2] Der Dumme in diesem Sinn ist also nicht der, der sich irrt, sondern der, bei dem Tatsachen keine Wirkung mehr entfalten dürfen. Die Brücke zum „Ist ja alles relativ“ besteht nur in einem Fall: Wenn das Relativieren nicht Unsicherheit ausdrückt, sondern Korrektur abwehrt, wirkt es wie die Immunisierung des Überzeugten.
Die Kognitionspsychologie kennt ein verwandtes, aber anderes Phänomen: den Dunning-Kruger-Effekt. Menschen mit geringer Kompetenz in einem Bereich neigen dazu, ihre Fähigkeiten zu überschätzen, weil ihnen die metakognitive Fähigkeit fehlt, die eigene Inkompetenz zu erkennen.[3] In der Studie von Kruger und Dunning von 1999 lag das unterste Quartil der Testleistung im Durchschnitt im 12. Perzentil, schätzte sich selbst aber im 62. Perzentil ein.[4] Der Effekt ist allerdings methodisch umstritten: Kritiker verweisen auf statistische Artefakte wie die Regression zur Mitte und auf den Better-than-average-Effekt.[5] Als Gesetz taugt er daher nur bedingt, als Beschreibung einer Tendenz erklärt er aber, warum nicht immer die am lautesten sprechen, die am meisten wissen. Zu diesem Typus passt eher der übermütige Draufhauer als der Relativierer. Beide können sich gegen Korrektur immunisieren, aber auf entgegengesetzten Wegen: der eine, weil er sich nie festlegt, der andere, weil er sich nicht belehren lässt.
Erstes Glied: der Raum. Kommentarspalten sind keine Meinungsumfragen. In einer niederländischen Befragung mit 5.490 Teilnehmenden hatten 78,2 Prozent im vorangegangenen Jahr Online-Nachrichten gelesen, aber nur ein Bruchteil schreibt jemals einen Kommentar.[6] Sichtbar sind ausschließlich jene, die schreiben, und die schreiben oft laut, emotional und angriffslustig. Online-Feindseligkeit geht, wie Bor und Petersen (2022) zeigen, vor allem von einer kleinen, statusorientierten Gruppe aus, nicht von der breiten Masse.[7] Elisabeth Noelle-Neumann beschrieb in den 1970er-Jahren die „Schweigespirale“: Wer seine Meinung in der Minderheit wähnt, zieht sich zurück, wodurch die vermeintliche Mehrheitsmeinung noch sichtbarer wird.[8] Empirisch ist dieser Effekt im Internet allerdings umstritten; Metaanalysen finden nur schwache bis heterogene Zusammenhänge.[9] Was daraus nicht folgt: Lautstärke beweist keine Dummheit, und auch Laute können recht haben. Belegt ist nur, dass Sichtbarkeit nicht nach Qualität vergeben wird, sondern nach der Bereitschaft, sich zu äußern, und nach Aufmerksamkeitswert. Dass „die Dummheit“ hier mehr Raum hat, ist deshalb eine Zuspitzung, die ich im Folgenden als Arbeitshypothese verwende.
Das Ausweichen selbst ist dabei oft weniger Dummheit als Kalkül. Die Sprachwissenschaftlerin Ruth Wodak beschreibt für soziale Medien das Prinzip der „Mehrfach-Adressierung“: Man muss für jeden etwas dabei haben, also bleibt die Sprache vage. Das Ergebnis ist ein Relativierungs-Sprech, der jede Position zurücknimmt, sobald sie auf Widerspruch stößt; „So habe ich das aber nicht gemeint“ ist die Standardantwort.[10] Das ist Imagepflege, nicht Dummheit im Sinne Bonhoeffers. Es ähnelt ihr nur in der Wirkung: Die Aussage wird unangreifbar, weil sie sich permanent entzieht. Für das Gespräch ist es dann fast gleichgültig, ob dahinter Taktik oder Tatsachenresistenz steckt, denn in beiden Fällen läuft die Korrektur ins Leere.
Zweites Glied: die Statistik. Hier beginnen die Maschinen. Große Sprachmodelle lernen zunächst aus riesigen Mengen Webtext, und was im Netz häufig vorkommt, prägt, was sie als normal abbilden. Schon Bender, Gebru und Kollegen haben 2021 darauf hingewiesen, dass internet-basierte Trainingsdaten dominante Sichtweisen überrepräsentieren, weil nicht alle im Netz gleichermaßen präsent sind und sich nicht alle gleichermaßen beteiligen.[11] Das ist verwandt mit der Sichtbarkeitsverzerrung der Kommentarspalten, aber nicht identisch: Es geht dort um demografische und gesellschaftliche Schieflagen, nicht um Lautstärke. Die Brücke ist eine Überlegung, kein Befund: Statistik kennt Häufigkeit, nicht Geltung. Ein System, das abbildet, was oft gesagt wird, bildet nicht ab, was stimmt.
Drittes Glied: das Weichspülen. Das Vortraining liefert, was häufig ist; die Glättung kommt später. Beim Nachtraining mit menschlichem Feedback (Reinforcement Learning from Human Feedback, RLHF) bewerten Menschen Antworten, und diese Bewertungen formen das Modell. Dabei zeigt sich ein Effekt, den die Forschung „Sycophancy“ nennt: Die Modelle neigen dazu, Überzeugungen des Nutzers zu bestätigen, auch wenn sie falsch sind. Sharma und Kollegen fanden, dass Antworten, die zu den Ansichten des Nutzers passen, eher bevorzugt werden, und dass sowohl Menschen als auch Präferenzmodelle überzeugend geschriebene, zustimmende Antworten in einem nicht vernachlässigbaren Teil der Fälle korrekten vorziehen; das Verhalten gehe, so die Autoren, zum Teil auf diese Präferenzen zurück.[12] Eine formale Analyse legt nahe, dass stärkere Optimierung zustimmendes Verhalten verstärken kann, wenn die Präferenzdaten Zustimmung höher belohnen als Korrektur.[13] Dass OpenAI im April 2025 ein Update von GPT-4o wegen übermäßiger Anbiederung zurücknahm, zeigt, wie real das Problem ist, und dass daran gearbeitet wird.[14] Hinzu kommt eine zweite Glättung: Kirk und Kollegen zeigten, dass RLHF die Vielfalt der Ausgaben gegenüber rein überwachtem Feintuning deutlich verringert.[15] Zustimmung und Einförmigkeit sind nicht dasselbe wie Relativierung, aber sie haben denselben Effekt: Es wird glatter, und die Ecken verschwinden. Sycophancy ist dabei keine Dummheit im Sinne Bonhoeffers, denn ein Sprachmodell verteidigt kein Vorurteil gegen Tatsachen. Sie wirkt aber wie dessen bequeme Dienerin: Wer ein Gegenüber hat, das ihm zuverlässig recht gibt, muss Tatsachen, die dem eigenen Vorurteil widersprechen, nie mehr glauben. Das ist meine Deutung, kein Befund der zitierten Studien.
Viertes Glied: der Sieg. Hier wird die Kette dünn. Was Maschinen ausgeben, landet wieder im Netz, und damit potenziell in den Daten künftiger Modelle. Shumailov und Kollegen zeigten in Nature, dass wahlloses Training mit modellerzeugten Inhalten zu „Modellkollaps“ führen kann, bei dem die Ränder der ursprünglichen Datenverteilung verschwinden.[16] Wenn man das auf unser Thema überträgt, und das ist eine Hypothese, die ich ausdrücklich als solche kennzeichne, dann gehören gerade bedingte, differenzierte Aussagen („Es gilt, wenn …“) zu den Rändern, die zuerst verloren gehen. Belegt ist die Rückkopplung als technisches Risiko; nicht belegt ist, dass sie den Diskurs tatsächlich in diese Richtung verschiebt. Ebenso offen ist, wie stark Menschen sich von KI-Antworten prägen lassen.
Damit zur Pointe, die ich bewusst vorsichtig formuliere: Dass die Dummheit siegt, ist die These dieses Essays, nicht sein Befund. Belegt ist, dass Sichtbarkeit nicht nach Qualität verteilt wird und dass Maschinen auf Gefälligkeit trainiert werden. Plausibel ist, dass beides zusammen verstärkt, was ohnehin laut ist. Offen bleibt, ob daraus mehr wird als ein Anschein von Macht. Der digitale Dumme ist nicht der, der nichts weiß, sondern der, der sich so sicher fühlt, im Ausweichen wie im Draufhauen, dass er nichts mehr lernen muss. Bonhoeffer blieb allerdings nicht beim Fatalismus stehen. Gegen die Dummheit helfe nicht Belehrung, schreibt er, sondern nur ein Akt der Befreiung, und er räumt ein, dass diese innere Befreiung die äußere Befreiung voraussetzt.[17] Übertragen auf den digitalen Diskurs, und das ist mein Gedanke und nicht seiner, heißt das: Es geht nicht darum, lauter zu schreien als die anderen. Es geht darum, den Unterschied zwischen echter Differenzierung und reflexivem Ausweichen wieder scharf zu stellen, in der eigenen Sprache und in den Maschinen, die wir trainieren. Wer diesen Unterschied verwischt, überlässt das Feld denen, die gar keinen mehr machen wollen.
Fußnoten
Dietrich Bonhoeffer: Widerstand und Ergebung, Dietrich Bonhoeffer Werke (DBW) Band 8, Abschnitt „Von der Dummheit“, Text aus dem Rückblick „Nach zehn Jahren“, entstanden Ende 1942, vor Bonhoeffers Verhaftung im April 1943. ↑
Ebd. ↑
Justin Kruger / David Dunning: Unskilled and unaware of it: How difficulties in recognizing one’s own incompetence lead to inflated self-assessments, in: Journal of Personality and Social Psychology 77 (1999), H. 6, S. 1121–1134. ↑
Ebd., Abstract: Das unterste Quartil lag mit seinen Testergebnissen im 12. Perzentil, schätzte sich selbst aber im 62. Perzentil ein. ↑
Vgl. Edward Nuhfer u. a.: Random Number Simulations Reveal How Random Noise Affects the Measurements and Graphical Portrayals of Self-Assessed Competency, in: Numeracy 9 (2016), H. 1; Gilles E. Gignac / Marcin Zajenkowski: The Dunning-Kruger effect is (mostly) a statistical artefact: Valid approaches to testing the hypothesis with individual differences data, in: Intelligence 80 (2020). ↑
Niederländische Befragung, referiert bei Mimikama: „Warum Kommentarspalten die Mehrheit oft falsch darstellen“, https://www.mimikama.org/kommentarspalten-mehrheit-meinung-verzerrt/. ↑
Alexander Bor / Michael Bang Petersen: The Psychology of Online Political Hostility: A Comprehensive, Cross-National Test of the Prevailing Explanations, in: American Political Science Review 116 (2022), H. 1, S. 1–18. ↑
Elisabeth Noelle-Neumann: Die Schweigespirale. Öffentliche Meinung – unsere soziale Haut, 1980. ↑
Jörg Matthes / Johanna Knoll / Christian von Sikorski: The „Spiral of Silence“ Revisited: A Meta-Analysis on the Relationship Between Perceptions of Opinion Support and Political Opinion Expression, in: Communication Research 45 (2018), H. 1, S. 3–33. ↑
Ruth Wodak, zitiert nach: Die Presse, „Sozusagen ein bisschen ein Problem“, https://www.diepresse.com/33774036/sozusagen-ein-bisschen-ein-problem. Die Darstellung folgt dem Zeitungsbericht. ↑
Emily M. Bender / Timnit Gebru / Angelina McMillan-Major / Shmargaret Shmitchell: On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?, in: Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency (FAccT ’21), S. 610–623, https://doi.org/10.1145/3442188.3445922. Der Abschnitt zu Trainingsdaten betont, dass große internetbasierte Datensätze hegemoniale Sichtweisen überrepräsentieren. ↑
Mrinank Sharma u. a.: Towards Understanding Sycophancy in Language Models, International Conference on Learning Representations (ICLR) 2024, arXiv:2310.13548. ↑
Itai Shapira / Gerdus Benade / Ariel Procaccia: How RLHF Amplifies Sycophancy, ICML 2026, https://icml.cc/virtual/2026/poster/63414. Sinngemäß: Wenn die Präferenzdaten zustimmenden Antworten höhere Belohnung geben als korrigierenden, kann stärkere Optimierung zustimmendes Verhalten verstärken. ↑
OpenAI: Sycophancy in GPT-4o: what happened and what we’re doing about it, 29. April 2025, https://openai.com/index/sycophancy-in-gpt-4o/. ↑
Robert Kirk u. a.: Understanding the Effects of RLHF on LLM Generalisation and Diversity, International Conference on Learning Representations (ICLR) 2024, arXiv:2310.06452. Befund: RLHF verbessert die Generalisierung, verringert aber die Ausgabevielfalt im Vergleich zu überwachtem Feintuning. ↑
Ilia Shumailov u. a.: AI models collapse when trained on recursively generated data, in: Nature 631 (2024), S. 755–759, https://doi.org/10.1038/s41586-024-07566-y. Die Autoren sprechen davon, dass bei wahllosem Training mit modellerzeugten Inhalten die Ränder („tails“) der ursprünglichen Verteilung verschwinden. Die Übertragung auf differenzierte Aussagen im Text ist eine eigene Hypothese. ↑
Bonhoeffer, Widerstand und Ergebung, a. a. O. (Fn. 1), Abschnitt „Von der Dummheit“. ↑
